异步 RL 框架的 Staleness,究竟怎么控制(一)?
随着大语言模型(LLM)的强化学习(RL)后训练越来越重要,如何高效地扩展 RL 训练系统,成为系统设计中的一个重要问题。为了提高 GPU 利用率和整体训练吞吐,越来越多的 RL 框架采用异步执行机制,将 rollout 和 training 解耦,使样本生成与模型训练能够并行推进,而不必严格同步等待。
然而,异步执行在提升系统效率的同时,也带来了一个问题:当生成的样本真正参与训练时,生成它的策略可能已经更新了多个版本。这种生成策略与训练策略之间的版本差异,通常称为 staleness(陈旧度)。
Staleness 越大,生成策略与训练策略通常越可能出现较大的偏离,样本也可能更加偏离当前策略的数据分布(即更具 off-policy 性),进而影响训练的稳定性与收敛表现。当然,具体影响还取决于 RL 算法和相应的校正方法。但无论如何,如何在提高系统效率的同时控制 staleness,都是异步 RL 框架需要面对的一大核心问题。
乍一看,这个问题似乎并不复杂。许多框架都提供了类似 max_staleness 的参数。将它设置为 1,或者放宽到 3,似乎就能限制样本的陈旧程度,让 rollout 和 training 各自独立运行。但问题是,max_staleness=3 究竟限制了什么?它真的能像我们想象的那样,保证所有参与训练的样本最多只落后 3 个策略版本吗?答案未必如此。
作为 PSRL 系列博客的第一篇,本文将聚焦于异步 RL 框架中的 staleness 控制,尝试回答两个问题:staleness 究竟可以在什么环节、通过什么机制进行控制?不同的 RL 框架又采用了哪些具体做法,这些做法分别能提供什么样的保证?我们将聚焦于主流 RL 框架,逐一分析其设计与实现。
源码说明:源码核对日期为 2026-10-16,选用当时各仓库默认分支的最新 commit,关键逻辑在正文引用。
Part I:Staleness 是怎么产生的?
1. 一条 Trajectory 的生命周期
一条 trajectory 通常从一个 prompt 开始。Prompt 是模型的输入,而 trajectory 则是模型基于该 prompt 生成的序列,由一个个 token 组成。在异步 RL 中,prompt 不一定会立即开始生成,系统通常需要先决定是否允许它进入 rollout。下文将这一动作统一称为准入(admission)。准入后,rollout 开始生成 trajectory。生成完成后,结果通常会进入 queue 或 buffer,等待训练侧取样。
对于 GRPO,同一个 prompt 通常会生成多条 trajectory,组成一个 group。训练侧从 queue/buffer 中选出 trajectory 或 group,这个动作称为训练取样。选出的内容由 batch assembler 组装成一个 batch,也就是本轮一起参与训练的内容。
在异步 RL 中,rollout 端和训练侧可以同时处理不同的 trajectory。rollout 端继续生成时,训练侧也在用之前收集的 batch 训练。因此,一条 trajectory 从开始生成到训练取样,可能经历多次策略版本更新。要准确描述它的 staleness,需要区分三个阶段:开始生成、生成完成后等待训练取样,以及被选入 batch 并参与训练。对于采用 partial rollout(允许一个 trajectory 使用多个版本拼接生成)的系统,还需要进一步区分同一条 trajectory 中不同 token 的生成版本。 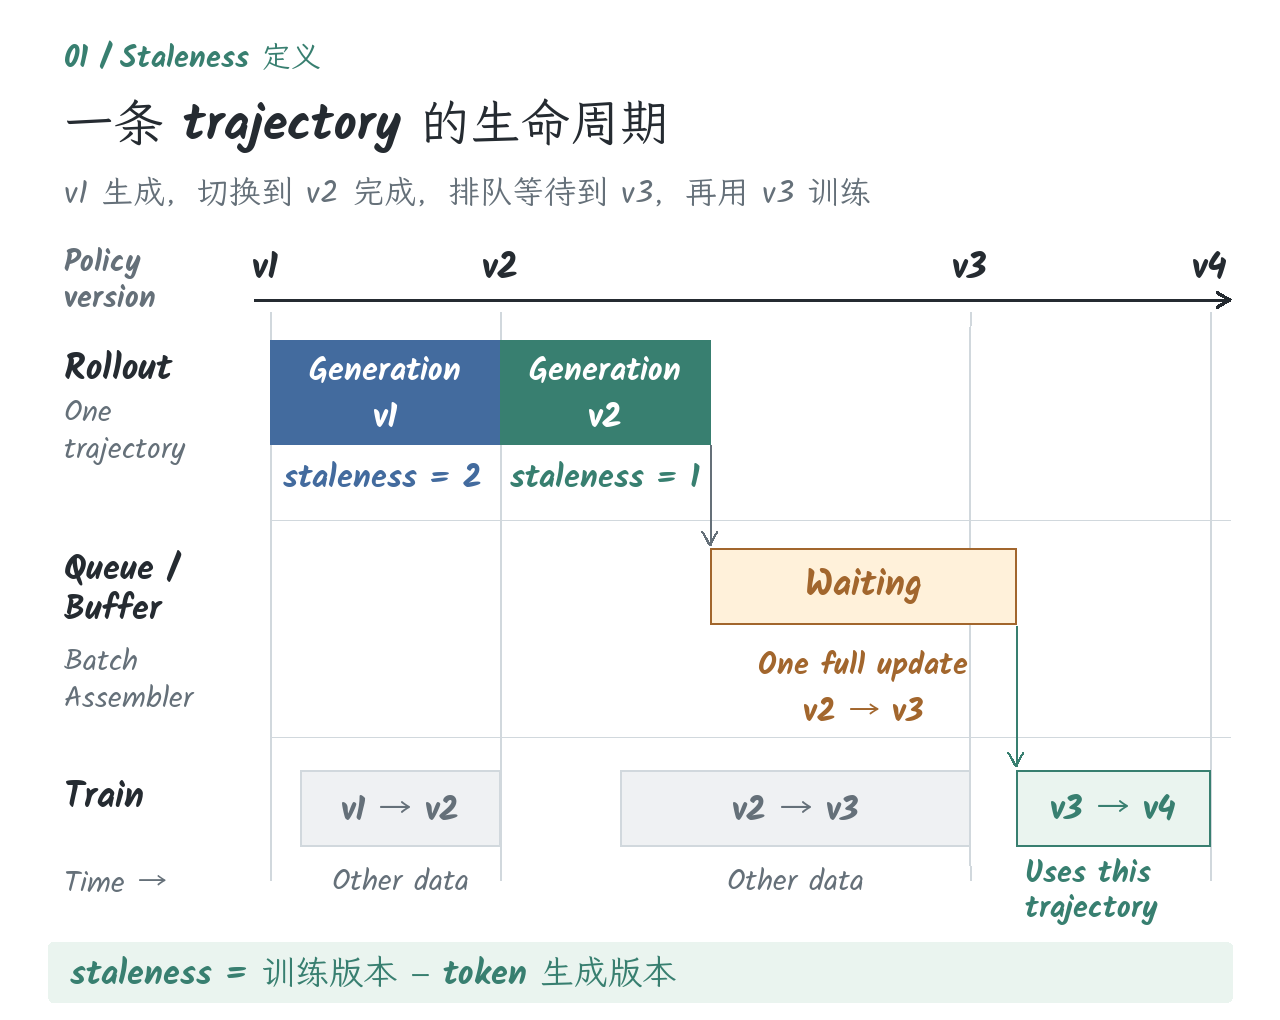
上图展示了一条 trajectory 的生命周期。它在模型版本 v1 时准入并开始生成。生成期间,训练侧完成一轮更新,得到 v2,并将新权重同步到 rollout 端。这条 trajectory 采用了 partial rollout:保留已经生成的前缀,再使用 v2 继续生成剩余部分。因此,同一条 trajectory 中可能包含由 v1 和 v2 分别生成的 token。
生成完成后,trajectory 也不一定马上参与训练。由于训练侧还在处理之前的 batch,它需要先在 queue 或 buffer 中等待。期间,训练侧继续从 v2 更新到 v3。直到训练侧使用 v3 时,这条 trajectory 才被取出并参与 v3 到 v4 的训练。
2. Staleness 的定义
顺着上面这个例子,staleness(陈旧度)就容易理解了。对一个 token,训练版本减去生成版本,就是它的 staleness:
\[\begin{equation*} \text{token staleness} = V_{\text{train}} - V_{\text{gen}} \end{equation*}\]图中这条 trajectory 在 v3 时参与训练,所以前半段 token 的 staleness 是 3 − 1 = 2,后半段则是 3 − 2 = 1。
从这个例子中我们不难看出,staleness 的来源由两部分构成:生成时的 staleness 以及排队等待时的 staleness。生成时间长,或者生成后等待得久,都可能让 staleness 增加,因为这两段时间里,训练侧都可能继续更新,跨过数个策略版本。
如果要用一个数描述整条 trajectory 的 staleness,我们可以取 trajectory 中最大的 token staleness。因此,图中示例 trajectory 的 staleness 就是 2,因为最早用 v1 生成的那部分内容,在训练时落后了两个版本。而对于 GRPO 的一个 group,我们类似地取组内全部 trajectory staleness 的最大值,作为这个 group 的 staleness。
因此,本文将“严格控制 staleness”定义为:设定上限后,系统能够保证所有实际参与训练的 token,其 staleness 都不超过该上限。例如,上限为 3,就要求每个参与训练的 token,其生成版本与训练版本之差不超过 3。平均 staleness 较低,或只在部分负载下观测到的 staleness 没有超限,都不足以证明系统提供了这一保证。被取消或丢弃、最终没有参与训练的 trajectory 不计入这一判定。
有了这个定义,接下来我们就可以进一步讨论:究竟该怎样控制 staleness?目前的异步 RL 框架的做法又能否真正限制住整个 RL 过程中的最大 staleness?
Part II:现有框架如何控制 Staleness?
3. 三个可以介入的位置
沿着 trajectory 的生命周期,我们观察到,系统其实可以在三个环节介入,来控制 staleness:(1)生成开始前,决定是否准入。(2)生成过程中,决定是否继续生成。(3)生成完成后,决定结果能否进入训练 batch。不同框架的实现方式有所不同,但都可以归入这三个环节。下文分别将它们称为 L1、L2 和 L3。
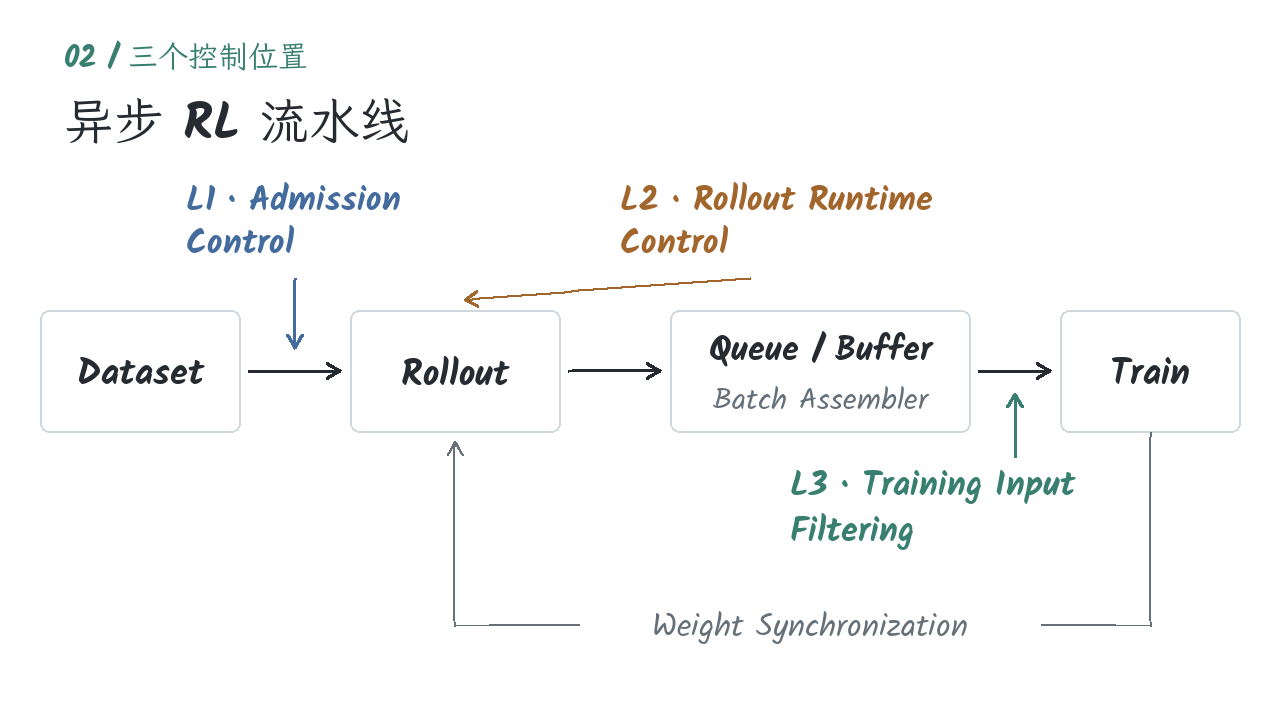
L1:准入控制(Admission Control)
prompt 还没开始生成时,系统要先决定是否准入。通过准入控制来实现 staleness 控制的想法很直观:准入量越大,同一时期就越可能出现更多低版本的 trajectory,它们参与训练时的 staleness 也可能越大。因此,有的框架会限制生成中的 trajectory 条数,有的还会把已经生成完成、尚未被训练取样的结果一起计数。达到上限后,就先暂停准入。准入何时恢复则取决于具体机制,例如生成完成、结果被训练侧取走,或训练版本推进后释放新的额度。
这一层最为直接且成本最低,因为被拦住的 prompt 还没有消耗生成计算。但问题也最为明显:只限制数量,并不意味着能够限制每条 trajectory 的 staleness。 假设系统最多允许 8 条 trajectory 同时生成,其中一条从 v0 开始后一直没有完成。与此同时,其余槽位不断生成较短的 trajectory,使训练侧能够持续组 batch 并将模型更新到 v5。此时,长 trajectory 仍只占用一个槽位,没有违反并发上限,但其中由 v0 生成的 token 若最终生成完成并参与 v5 的训练,其 staleness 就会高达 5。
因此,L1 层面的控制可以减少数据积压,但仅靠数量限制,无法保证每条 trajectory 的 staleness 都不超过阈值。
L2:Rollout 运行时控制(Rollout Runtime Control)
准入后,trajectory 就开始生成了。系统可以在权重更新或同步等特定时机检查仍在生成的 trajectory,并取消那些已经不可能满足 staleness 上限的任务。具体检查时机、比较的版本以及取消条件取决于框架实现。
例如,一条 trajectory 从 v1 开始生成,到 v5 仍未结束。若允许的最大 staleness 为 3,此时版本差已达 4,系统便可在本次版本推进时取消它,无需等其完整生成后再处理。取消越早,节省的后续计算越多。但无法避免的是,此前已生成的 token 会被浪费。
仅增加 L2 层面的控制仍不够:trajectory 生成完成后仍可能排队,而 L2 是无法覆盖这段排队中的等待时间的。trajectory 可能通过 L2 检验,却在后续排队过程中最终超过 staleness 上限。
L3:Training 前过滤(Training Input Filtering)
生成完成后,trajectory 通常会在 queue 或 buffer 中等待训练侧取样。系统可以按 FIFO(先进先出)等策略选择结果,也可以在取样或组装 batch 时检查其版本信息,将超限的 trajectory 或 group 排除在训练 batch 之外。被排除后,框架可以继续取样以补齐 batch,也可以按其实现采用其他处理方式,具体取决于训练流程的设计。
L3 最接近训练入口,也是实现严格 staleness 控制最直接的位置。 到了这里,系统可按实际训练版本检查 trajectory,只让合格结果进入 batch。但是,在 L3 进行控制的代价也很明显:若此时才丢弃,整条 trajectory 的生成计算便白费了。因此,L1 是否限制了过量准入、L2 是否提前终止了超限生成,都一定程度上决定了 L3 会浪费多少。若大部分 trajectory 都能及时参与训练,L3 也可能很少触发丢弃。
4. 不同框架的三层机制
接下来,我们把 L1–L3 的分层逻辑对照到当前主流的异步 RL 框架中,看看各框架具体是怎么做的。
下图汇总了 10 个框架的做法:L1–L3 三列用勾/叉表示该框架是否在对应层级采取了控制动作。最后一列则回答我们最终关心的问题:能否保证所有训练 token 都不超限?
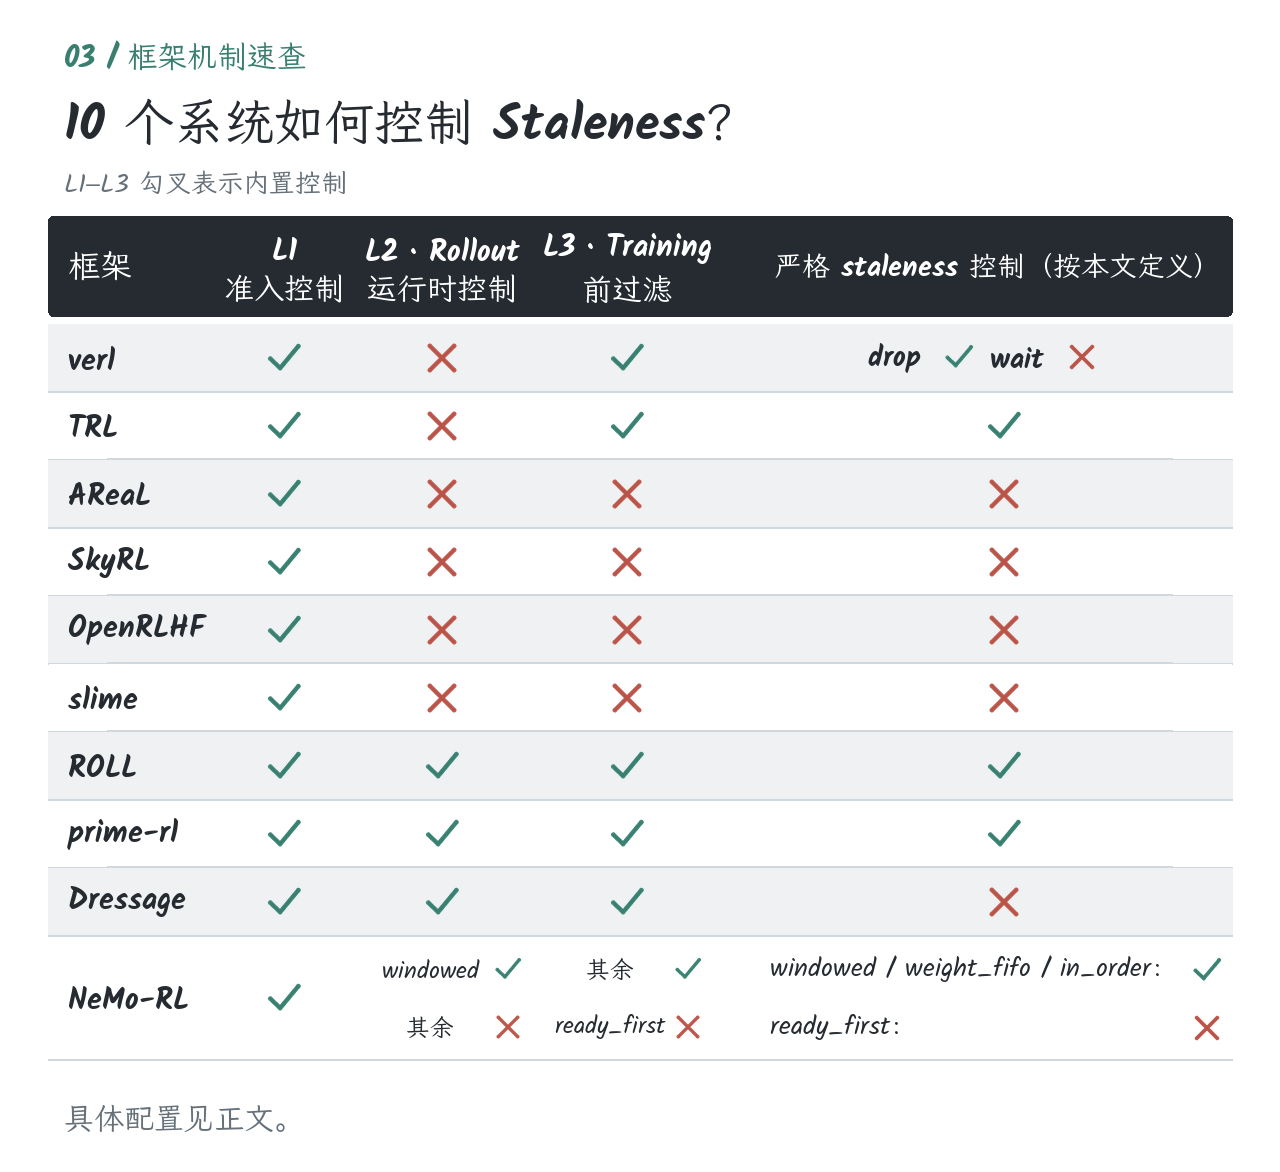
下面,你可以点击具体框架的名称,展开查看详细分析。
4.1 verl
我们先看 verl(关注其异步训练模式,对应配置是 trainer.v1.trainer_mode=separate_async)。它允许通过 max_off_policy_threshold 设置阈值,再用 max_off_policy_strategy 选择超限时怎么处理:丢弃(drop),或者等待(wait)。
L1: verl 按训练进度补充准入。其通过参数 num_warmup_batches 来控制训练开始前额外预取多少批 prompt。之后每进入一轮训练,还会正常准入 train_batch_size 个 prompt。因此,实际准入的数据由启动预取与每轮正常准入两部分构成。例如,设 train_batch_size=4、num_warmup_batches=4,启动时先额外准入 4 × 4 = 16 个 prompt,首轮再正常准入 4 个,合计 20 个。之后每轮训练更新后,再不断准入 4 个。
L2: 不进行 staleness 控制。
L3: prompt 准入时,verl 会记下当时的训练轮次 global_steps。等到训练侧从 buffer 取样,再看这个 prompt 已经等了多少轮。drop 和 wait 都用这个计数,但超限后的处理不同。
drop:超限就丢弃。 如果下面的检查值超过阈值,就丢弃整个 group:
if global_steps - prompt_global_steps.get(uid, global_steps) + 1 > self.max_off_policy_threshold
过滤后,buffer 会重新准入同样数量的新 prompt,继续等待足够的合格 group,选出的 batch 还会再次接受检查。
wait:在取样处等慢 group 完成。 训练开始前,只要有任何一个尚未生成完的 group 满足 global_steps - prompt_global_steps + 1 >= max_off_policy_threshold,这次训练就需要停等,即使 buffer 中已经有足够的已完成 group。等这些达到阈值的 group 完成,并且可取的已完成 group 数量达到本轮 batch_size 后,buffer 才会按准入版本从早到晚选择 group,交给训练侧开始训练。
不过,等到完成,不等于一定能在本轮被训练取样:每次取样只会选出本轮需要的 batch_size 个 group,已经完成的 group 可能因为 batch 容量有限继续留在 buffer 中。而 wait 的等待条件只检查尚未生成完的 group,因此一个 group 一旦完成生成,即使它后来已经超过阈值,也不会因 staleness 被再次过滤或丢弃。
沿用 L1 的例子:启动预取和首轮准入后一共有 20 个 prompt,每轮取 4 个 prompt 的结果组成训练 batch,并更新一个版本。假设用户设定 max_off_policy_threshold=3。这个阈值并不会影响 L1 已经安排的预取量。如果这 20 个 prompt 都用 v0 很快完成,那必定会有 trajectory 要放到 v4→v5 的训练 batch 中,此时 staleness 已经是 4。如果部分 v0 的 trajectory 尚未完成,而 v1 时准入的 4 个 prompt 更快完成,就可能先用这批 v1 的结果训练,进一步把剩余 v0 结果推迟到 v5→v6 的训练(v0 的 prompt 在 v1 时还不需要 wait,因为还没达到 max_off_policy_threshold=3 的边界)。
源码中的对应测试也单独验证了 wait 的这一行为:已经完成的超限 group 仍会被返回,无法保证 staleness 上限。
分析: verl 采用了两种不同的 L3 策略,区别在于已经完成的超限 group 还能不能参与训练。drop 会淘汰这些 group,因此可以根据每轮实际更新次数,把它的阈值换算成训练 token 的 staleness 上限。wait 则只让训练等慢 group 完成,不会淘汰已经完成的超限结果,因此不能保证严格上限。
配置说明:将
max_off_policy_threshold设为null时,不执行这两种 L3 策略,此时只由 L1 限制准入量。这种配置下同样不能保证严格 staleness 控制。
4.2 TRL
下面来看 TRL,我们聚焦于其提供的异步 GRPO 训练方案(Async GRPO recipe),它允许通过 max_staleness 参数来控制 staleness 上限。
L1: TRL 用 max_inflight_tasks 限制同时发给 vLLM 生成的任务数。生成完成后就释放位置,有空位就准入新任务,不必等训练侧取样。同一个 prompt 生成的多条 trajectory 分别计数。若未手动设置,系统会按每轮训练消费的 trajectory 数乘以 max(max_staleness, 1) 推导默认上限。比如每轮训练消费 32 条 trajectory,max_staleness=3 时默认上限是 96 条 inflight trajectory。max_staleness 为 0 或 1 时,仍至少给出 32 条容量,以保证 rollout 调度不会因容量为零而停住。参数含义见配置。
L2: 无 staleness 控制。
L3: TRL 在训练读取结果时,由 RolloutQueueDataset 用当前训练版本减去 trajectory 记录的生成版本 model_version,超过 max_staleness 就丢弃:
version = self.model_version_fn()
staleness = version - sample.model_version
if staleness > self.max_staleness:
    logger.info(f"dropping stale sample (staleness={staleness}, max={self.max_staleness})")
    self.metrics["sample/dropped_stale_total"].append(1.0)
    continue  # drop stale, pull next
源码:RolloutQueueDataset 的训练取样分支。
代码里的 continue 意味着这一条不会交给训练侧,而是继续取下一条。trajectory 携带的版本来自 group 首次建立时,也不会在生成完成后被新版本覆盖。
分析: 和 verl 的 drop 一样,TRL 会在 L3 排除超限 trajectory,因此可以做到严格 staleness 控制。
4.3 AReaL
L1: AReaL 有专门的 StalenessManager 模块来控制准入,允许通过 max_head_offpolicyness 配置生成提前量。类似于 verl,它让准入额度随训练进度推进,核心公式如下:
sample_cnt = self.rollout_stat.accepted + self.rollout_stat.running
consumer_bs = max(1, self.consumer_batch_size)
staleness_capacity = (ofp + current_version + 1) * consumer_bs - sample_cnt
源码:get_capacity(),其中 ofp = max_head_offpolicyness。
公式看起来有些长,核心其实就是两个计数:running 记录仍在生成的 prompt 数,accepted 累计记录已经生成完成并通过接收检查的 prompt 数,包括已经被训练取样的部分。一个 prompt 完成生成,只是从 running 转到 accepted,两者之和没有减少,所以不会释放准入额度。真正增加额度的是训练版本推进:current_version 每增加 1,就多给一个 batch 的额度,consumer_bs 就是这个 batch 的 prompt 数。而公式最后算出的 staleness_capacity,就是当前还可以准入 prompt 的数量。
例如,每个 batch 有 32 个 prompt、max_head_offpolicyness=1,初始版本 v0 的累计准入额度就是 (1 + 0 + 1) × 32 = 64。在并发上限允许的情况下,可以先准入 64 个 prompt。它们全部生成完成,也不会带来新额度。等训练完成一次、版本推进到 v1,才再增加 32 个 prompt 的额度。最终实现的效果和 verl 的 L1 相近:先允许提前额外生成一段,再跟着训练进度补充准入。
L2: 无 staleness 控制。只在 prompt 完成生成时,更新前面介绍的 running 和 accepted 计数。
L3: AReaL 会测量 token staleness,记录平均值、最小值、最大值和旧 token 占比。不过,这段staleness 统计不会移除超限 trajectory。
分析: AReaL 无法做到严格 staleness 控制。和最开始介绍 L1 时讲的例子一样,一个 prompt 无论生成多久,都只占一个 running 额度。只要其他 prompt 足以让训练继续,新的版本和额度就会不断产生,慢 trajectory 仍能继续生成。AReaL 又没有 verl drop 或 TRL 那样的训练前淘汰步骤,因此 max_head_offpolicyness 只能控制准入,不能直接当成每个训练 token 的 staleness 上限。
4.4 SkyRL
L1: SkyRL 沿用了 AReaL 的额度思路,源码也注明了这一点。类似地,其提供了参数 max_staleness_steps,来决定初始能提前生成多少,之后跟着训练进度补充额度,再扣除累计完成和仍在生成的 prompt 数。额度用完就暂停准入,训练每完成一轮,再增加一个 batch 的额度。
L2: 无 staleness 控制。
L3: SkyRL 取样时会检查 group 从准入到现在经历了多少轮训练,也就是 global_step - global_step_when_scheduled。超过 max_staleness_steps 后,它会打印 warning 并累计超限次数。至于要不要丢弃,源码留下了这样一个问题:
# TODO(Charlie): should we drop, drop and resample, or just log?
当前这个版本的选择是“只记日志”,并不会将超限的 group 从训练 batch 中移除。
分析: 与 AReaL 相比,SkyRL 多了训练取样时的超限告警,但没有进一步丢弃。它能发现某个 group 的 staleness 超限,却仍会训练这个 group,所以也不能保证最大 staleness 不超过配置值。
4.5 OpenRLHF
L1: OpenRLHF 同样限制生成侧的工作量,不过准入额度的用法与 AReaL 不同。可以把它理解成以 batch 为粒度的固定数量的生成许可:生成侧每准备一批结果,就先取走一个许可,用完便等待。结果放进 queue 后,要等训练侧取出这一批结果,才会归还许可。许可数量由 async_queue_size 决定。
例如,async_queue_size=2 就有两个许可。生成中的 batch 和已经生成、等待训练取样的 batch 合计占满两个许可时,就暂停准备下一批。训练侧取走其中一批,许可随即归还,生成侧便能继续,无须等这轮训练完成。
L2: 无 staleness 控制。
L3: 无 staleness 控制。
分析: OpenRLHF 和 AReaL、SkyRL 类似,都只是在 L1 限制工作量,不过具体也存在一定的区别。首先,是准入粒度的不同:OpenRLHF 以 batch 为粒度去计数和准入,而 AReaL 与 SkyRL 则是以 prompt 为粒度。其次,是恢复准入的时间不同:OpenRLHF 在训练取样时归还许可(刚进入训练),AReaL 和 SkyRL 则要等训练版本推进(刚完成训练),才增加下一批累计额度。不过,三者都没有根据单条 trajectory 的生成版本决定它还能否参与训练,因此不能仅靠这些数量限制严格控制 staleness。
4.6 slime
类似上述框架,slime 也主要在 L1 通过限制工作量控制准入(这里关注 slime 的完全异步模式)。
L1: 相关超参主要有两个。sglang_server_concurrency 设置每个 SGLang 引擎的 trajectory 并发预算,fully_async_group_prefetch_factor 则控制允许提前处理多少个 prompt,默认是 1。系统先汇总各引擎的并发预算,再除以每个 prompt 的 trajectory 数 n_samples_per_prompt,最后乘上预取系数,得到 prompt 数量阈值,具体见阈值计算。
例如,只有一个引擎,设置 sglang_server_concurrency=64、n_samples_per_prompt=8、fully_async_group_prefetch_factor=1,阈值就是 64 ÷ 8 × 1 = 8 个 prompt。正在生成的 prompt 达到 8 个,或者已经完成、等待训练取样的结果来自 8 个 prompt,就暂停新 prompt 的准入。只有这两部分都少于 8 个,才继续准入。值得一提的是,这里分别检查两部分的数量,并不是把二者相加限制在 8 个以内。
这也解释了准入如何恢复:原来的 8 个 prompt 中有一个完成,只要完成结果 queue 也未达到 8 个,就可以再准入一个,不必等训练版本更新。
L2: 无 staleness 控制。
L3: 训练侧从完成结果的 queue 中取样,直到凑够 rollout_batch_size 个 prompt 的结果,多余的留给下一批。slime 会统计 rollout 当前版本与 trajectory 最早生成版本的差,但内置取样逻辑没有据此删除超限 trajectory。
分析: slime 和前面几个框架的 L1 层设计思路相近,都是通过限制工作量减少积压,只是具体计数有所不同:slime 只要上述两部分数量都低于阈值,就可以继续准入,AReaL 等框架则是要遵守累计准入额度。不过,之前同样的问题依然不变:一个慢 prompt 可以一直占着一个生成额度,最终导致 staleness 超限。
4.7 ROLL
ROLL 提供了一个核心的 async_generation_ratio 参数来表示 staleness 上限。下面用 async_generation_ratio=2、每批 32 个 prompt 作为例子,把 L1–L3 串联起来看。
L1: 类似于上述框架,ROLL 也按训练进度补充准入额度。首轮在正常 batch 之外,额外增加 ceil(batch_size × async_generation_ratio) 个 prompt 的额度,其中 ceil 表示向上取整。代入上面的例子,额外额度为 ceil(32 × 2) = 64,加上正常的 32 个,首轮总额度就是 96 个 prompt,此后每轮再增加 32 个。负责分配生成任务的调度器会把正在生成和累计完成的 prompt 数相加,额度用完就暂停准入。
L2: ROLL 会取消不能再用于下一轮训练的生成任务。上面的例子中,async_generation_ratio=2 允许的最大 staleness 为 2。在 v5 训练取样时,v3 开始生成的 trajectory 仍可使用,但到了 v6 就会超限。所以,在 v5 这批取样完成后、下一轮同步权重之前,调度器会清理 v3 及更早版本开始的任务,其中仍在生成的任务会被永久取消。
L3: 训练取样同样检查开始生成时记录的版本。当前训练版本为 v5 时,只从 v3、v4、v5 开始生成的 trajectory 中组装 batch。取样时先从最早允许的 v3 开始,再从 v4、v5 补齐本批。
分析: async_generation_ratio 同时参与了 L1 的准入额度、L2 的运行中取消和 L3 的训练取样。与只在 L1 限制工作量的框架不同,ROLL 通过 L2 与 L3 限定了每个 trajectory 实际最晚能用于哪个训练版本,因此可以严格控制 staleness。
4.8 prime-rl
L1: prime-rl 先用 max_inflight 限制同时运行的生成数量。负责生成调度的模块会检查还有多少空位,有空位才继续准入,生成完成后再释放。这个数量限制与前面几个框架的思路相近。
L2: 对使用当前训练策略生成的 group,prime-rl 会在新权重即将发布时检查:这个 group 最早的生成版本,还能否用于接下来的训练?早于允许版本的 group 会被逐组取消。
L3: 生成完成的 group 会交给 TrainSink,由它检查版本并组装训练 batch。它和 L2 使用同一条规则,计算本轮训练允许的最早生成版本:
def min_fresh_version(step: int, max_off_policy_steps: int) -> int:
    return (step - 1) - max_off_policy_steps
说明:这里的
step是训练轮次,对应的训练版本是 step − 1。减去max_off_policy_steps,得到的就是允许参与这轮训练的最早生成版本。
TrainSink 逐条检查 trajectory 记录的最早生成版本 policy.start,早于允许版本就从待训练结果中删除。版本推进时,已经排队的 trajectory 会重新检查,新到的 trajectory 也一样。过滤后还要继续凑齐 batch,才会开始训练。
例如,训练版本为 v5、max_off_policy_steps=2 时,只接受最早生成版本不低于 v3 的 trajectory。
分析: prime-rl 的三层配合与 ROLL 很接近:L1 限制工作量,L2 提前取消已经不可能参与训练的生成,L3 再检查实际要用于训练的 trajectory。区别在于,ROLL 用 async_generation_ratio 同时决定准入额度和允许的版本范围,prime-rl 则把准入上限 max_inflight 与 staleness 上限 max_off_policy_steps 分开配置。两者都不只依靠 L2 取消,生成后因排队而超限、或者取消时恰好完成的 trajectory,还要经过 L3 检查。因此,L2 只是用来减少无效生成,L3 才是真正保证实际参与训练的 token 不超过 staleness 上限的关卡。
4.9 Dressage
L1: 与上述框架一样,Dressage 也通过限制工作量控制准入:正在生成的 group 不能超过 max_active_groups,在 output_queue 中等待训练取样的结果也不能积压太多。这里的 output_queue 就是 rollout 完成后、组装训练 batch 前存放 group 的队列,对应流水线图中的 L3 等待区域。它达到容量的 80% 时,就暂停新 prompt 的准入。已经开始的生成仍会继续,队列完全装满时,完成结果需要等空位才能写入。
L2: Dressage 还会检查 partial rollout 到底使用了多少个生成版本。它汇总已有前缀和本次响应的版本,去重后,用 max_partial_rollout_preempts 限制不同版本的数量:
version_span = len(versions)
version_switches = max(0, version_span - 1)
if version_switches <= max_partial_rollout_preempts:
    return
源码:_raise_if_partial_version_span_exceeded()。
例如设成 2,最多允许使用 3 个不同版本,出现第 4 个时就中止这次 trajectory。这里数的是参与生成的版本数量,而不是最早生成版本与训练版本之间的差。
L3: 生成完成后,Dressage 还会根据每条 trajectory 最后一个 token 的生成版本过滤结果。参数 dressage_staleness_keep_versions 决定接受其中多少种版本。比如设成 2,假设收集到的结果先后出现了末尾版本为 v1、v2 的 trajectory,此时两种都可以接受。随后第一次收到末尾版本为 v3 的结果,就只接受末尾版本为 v2、v3 的 trajectory。如果一个 group 中有任意一条 trajectory 的末尾版本为 v1,整个 group 都会被丢弃。
这个检查发生在从 output_queue 收集结果、组装 batch 时。如果本批已经收集了一些 v1 的 group,但尚未凑齐 batch 就收到了 v3 的结果,先前收集的 v1 group 也会被删除,再继续收集补齐。源码中的版本记录与过滤逻辑实现的就是这套规则。这里的版本顺序按不同版本首次出现在已收集结果中的先后记录,不按版本编号排序。旧版本再次出现,也不会改变这个顺序。因此,设成 2 并不代表接受落后训练版本不超过 2 的结果。
分析: 相比 slime,Dressage 在 L2、L3 都增加了实际淘汰动作。不过,L2 限制的是参与生成的版本数量,L3 检查的又只是末尾 token 的生成版本。比如一条 trajectory 用 v1 开始、用 v2 完成,只要末尾版本 v2 仍符合上述条件,它就可以通过 L3,前面用 v1 生成的 token 并不会单独检查。而且,L3 的筛选条件随着收集到的结果更新,并没有对照实际训练版本。因此,通过过滤并不代表每个 token 的 staleness 都满足上限。Dressage 因而仍不能按本文定义严格控制 staleness。
4.10 NeMo-RL
NeMo-RL 用一个统一控制器协调生成和训练,并提供四种 sampler 来决定准入方式和训练取样策略。表中先给出它们在三层上的区别。
| sampler | L1 | L2 | L3 | 严格 staleness 控制(按本文定义) |
|---|---|---|---|---|
windowed | ✓ | ✓ | ✓ | ✓ |
weight_fifo | ✓ | ✗ | ✓ | ✓ |
ready_first | ✓ | ✗ | ✗ | ✗ |
in_order | ✓ | ✗ | ✓ | ✓ |
NeMo-RL 提供了一个 max_staleness_versions 核心参数,其在不同 sampler 中管的事情不同:windowed 用它过滤超限 group,weight_fifo 同时用它限制准入提前量和过滤超限 group,ready_first 只用它限制准入提前量。in_order 则用一个单独的 max_lookahead_versions 限制准入提前量,并在准入时指定每批结果对应的训练版本。下面按三层展开,具体实现可对照四种 sampler 的代码。
L1: 四种 sampler 都有两项共同的容量限制。max_inflight_prompts 限制同时生成的 prompt 数,max_buffered_rollouts 则限制已准入、尚未被训练用完或丢弃的 group 总数。后一项从开始生成前就为 group 预留容量,因此正在生成的结果也算在内。
weight_fifo 和 ready_first 在此基础上,还用 max_staleness_versions 限制准入最多能领先训练多少批。比如每批 32 个 prompt,参数设为 2。容量充足时,训练还在 v0 就最多放行三批,共 96 个 prompt。额度用完后,即使部分 prompt 已完成生成,也不会因此多放行一批,而是要等训练推进到 v1 才能继续。这与前面 verl、AReaL 等框架随训练版本增加累计准入额度的思路相近。
in_order 也按这套规则限制准入,但参数叫 max_lookahead_versions。它还会为每批 prompt 指定目标训练版本,后面 L3 会用到这个标记。windowed 则没有这项按训练进度增加的批次额度,只受前面两项容量限制。只要并发和 buffer 容量允许,它就可以继续准入,无须等训练版本推进。它的 max_staleness_versions 用在 L2、L3,表示允许的实际 staleness 上限。
L2: 只有 windowed 会按 staleness 取消仍在生成的 group,检查发生在权重同步前。例如当前训练版本为 v5、max_staleness_versions=2,最早生成版本早于 v3 的 group 就会被中止。其他三种 sampler 没有这项取消。
L3: windowed 和 weight_fifo 都会比较每个 group 的最早生成版本与当前训练版本,并用 max_staleness_versions 过滤超限结果。比如训练版本为 v5、参数设为 2,两者都只取最早生成版本在 v3 到 v5 之间的已完成 group。区别在于,windowed 可以混合选取这些版本下已完成的 group,weight_fifo 则先选其中最早的生成版本。如果这个版本已完成的 group 还没达到最低取样数量,它会继续等待,而不会拿更新版本的 group 来补齐。
ready_first 则优先取已经完成的 group,不检查它们最多落后训练多少版本,也不淘汰超限结果。它的 max_staleness_versions 只在 L1 起作用。慢 group 可以被后来的快 group 绕过,让训练继续推进,自己直到多个版本之后才参与训练。
in_order 不按版本差过滤,而是只取准入时指定用于当前训练版本的 group。沿用 L1 的例子,设 max_lookahead_versions=2,训练还在 v0 时准入的三批 prompt 分别指定给 v0、v1、v2 训练。其中指定给 v2 的那批,结果再早完成也要等到 v2 才取样。如果尚未准备好,训练就在 v2 等待,不会先跳到 v3 再用它。因而在生成权重随训练版本同步的正常训练流程下,这项提前量限制也就形成了 staleness 上限。
分析: NeMo-RL 提供了三种严格保证 staleness 上限的做法:windowed 和 weight_fifo 在训练取样时按最早生成版本过滤,in_order 则在准入时提前安排好训练版本。值得注意的是,in_order 下,慢请求会让训练等待,但它等的是指定给本轮的结果,这与 verl 的 wait 只等待生成完成、完成结果仍可能留到后续训练有所不同,因此可以保证严格 staleness 控制。与上述三种配置不同,ready_first 则只有 L1 的工作量限制,无法保证每条 trajectory 的 staleness 上限。
Part III:小结
把这 10 个框架放在一起看,staleness 控制大致可以分成两类。一类主要在 L1 限制准入量,AReaL、SkyRL、OpenRLHF 和 slime 都属于这一类,NeMo-RL 的 ready_first 配置也是如此。它们通过限制准入、并发或待处理工作量,减少系统里的积压。这类做法比较简单,不需要为了限制 staleness 而丢弃数据,但局限也很明显:一个慢 prompt 对应的 trajectory 仍可能跨过许多训练版本,单靠总体数量限制,无法保证个体 trajectory 参与训练时的 staleness 上限。
另一类是 verl、TRL、ROLL、prime-rl、Dressage,以及 NeMo-RL 的其他三种配置。它们在 L1 之外,还会在 L2、L3 的一个或两个位置采取控制。不过,多一层控制并不一定就能保证严格的 staleness 上限,例如 verl 的 wait 就做不到。在本文考察的实现中,真正提供严格上限的方案,几乎都涉及在 L3 丢弃超限的生成结果。这也不难理解:L3 最接近训练入口,按训练版本检查并排除超限结果,是实现严格 staleness 控制最直接的办法。
对于这类依靠丢弃保证 staleness 上限的方案,从某种角度看,L1 限制准入、L2 提前结束超限生成,都可以理解为是在减少到了 L3 才丢弃所造成的浪费。不过,具体该如何配置,并不是一个简单的问题。例如,不少框架把准入限制和 staleness 上限拆成了不同的参数。L1 准入限制得更紧,通常能减少之后超限和被丢弃的结果数量,却也可能压低 rollout 吞吐。放宽准入能让生成端保持忙碌,却可能增加 L3 的丢弃比例,浪费更多生成计算。怎样配合这些参数,在满足 staleness 上限的同时取得更好的训练吞吐,值得进一步探讨。
此外,另一个很有意思的问题是,严格控制 staleness,一定要靠 L3 的丢弃吗?NeMo-RL 的 in_order 其实提供了另一条路线:准入时先指定结果对应的训练版本,限制生成最多能提前多少个版本,结果未就绪时就让训练等待。它通过准入和训练取样的配合维持版本约束,无须依靠按 staleness 丢弃来保证上限。但这样的代价是训练取样的灵活性更低:在尚不知道每条 trajectory 需要生成多久时,就已经决定了它用于哪个训练版本。遇到长尾生成,训练可能需要长时间等待,整体吞吐可能受到影响。
由此,我们想进一步深入探讨下面两个话题:
1. 不同控制机制的实际表现如何? 对于许多仅仅依靠 L1 的 RL 框架,调节准入参数后,实际最大 staleness 会怎样变化,是否真的会出现前文分析的 staleness 超限现象呢?而对能够严格控制 staleness 的框架,L1、L2 的参数又该如何配合,才能减少丢弃并维持吞吐?在相同资源和负载下,这两类机制的 RL 吞吐又会有多大差别?
2. 能否设计更灵活的控制机制,既不丢弃数据,又能保证最大 staleness? NeMo-RL 的 in_order 提供了一个值得借鉴的思路:提前安排训练数据的排布,而不是等到训练前再临时筛选。不过,它在生成之前就将每批数据与训练版本固定对应,遇到长尾生成时,训练就需要等待。我们可以沿着这一思路继续深入思考,能否在保证 staleness 上限的同时,更灵活地安排生成与训练,减少长尾等待?
我们将在后续两篇博客中继续讨论这两个问题。欢迎关注我们的 RL 项目 PSRL,如果这份博客对你有帮助,希望你可以顺手点个 star⭐,你的支持将是我们继续分享的动力!